RAG 完整详细流程(检索增强生成):原理、架构与实战

提问
RAG(Retrieval‑Augmented Generation,检索增强生成)的完整详细流程是什么?每个环节具体怎么做?常见变种有什么区别?
参考答案
RAG 核心思想:大模型本身知识是静态训练数据,通过外部知识库检索拿到实时私有资料,拼入 Prompt,交给 LLM 生成答案——解决幻觉、私有数据问答、知识更新三大难题。
整体分两大阶段:
- 索引构建阶段(离线,一次性 / 定时执行):文档入库处理
- 推理查询阶段(线上,用户每提问一次跑一遍):Query → 检索 → 组装 Prompt → LLM 生成
第一阶段:离线索引构建(文档处理流水线)
1 | 原始文档 → 文档加载 → 解析清洗 → 文本分块 → Embedding → 存入向量库 |
1. Document Load 文档加载
读取各种来源文件,输出原始文本。
- 文件:PDF、docx、md、txt、excel
- 网页:爬虫抓取
- 数据库:MySQL、业务表字段
- 接口:业务 API 返回文本
⚠️ 坑:PDF 扫描件是图片,需要 OCR 识别,否则拿不到文本。
2. 文档解析 & 文本清洗
- 去除页眉页脚、页码、广告、多余换行、特殊符号、乱码
- 表格:尽量转成文本描述(Markdown 表 / CSV / 文本行)
- 图片:需要 OCR / 多模态 LLM 描述图片内容
输出:干净的长文本。
3. Chunking 文本分块(RAG 最关键环节之一)
把长文档切为小块(chunk),不能直接把整本书丢给向量库。
为什么必须分块:
- Embedding 模型有输入长度限制(512-8192 token)
- 检索以 chunk 为最小单元;chunk 太大语义混杂,chunk 太小丢失上下文
常见分块策略
| 策略 | 原理 | 适用 |
|---|---|---|
| 固定字符分割 | 按字符数切,保留 overlap | 通用场景 |
| 递归字符分割 | 优先按换行/段落/句子/字符逐层切(LangChain 默认) | 文档结构清晰 |
| 语义分块 | 嵌入向量相似度突变处切分 | 高质量需求 |
| 标题感知 | 按 markdown 标题层级切分 | 结构化文档 |
⚠️ overlap 重叠至关重要:防止一个完整语义被一刀两断。一般 10-20% 重叠率。
输出:Document(chunk_text, metadata),metadata 含来源文件、页码、章节、时间等。
4. Embedding 文本向量化
把每个 chunk 送入 Embedding 模型,输出稠密向量(float 数组)。
- 开源:bge-v3、m3e、all-MiniLM、bge-m3(多语言)
- 闭源:OpenAI text-embedding-3、阿里 text-embedding-v3
⚠️ 关键:查询阶段必须用同一个 Embedding 模型,模型换了向量空间不一致,检索直接失效。
5. 写入向量数据库
向量库存储三部分:向量 + 原始 chunk 文本 + metadata。
主流向量库:Milvus、Chroma、FAISS、PGVector(Postgres 扩展)、Qdrant、Doris
⚠️ 向量库只负责向量相似度搜索,不理解语义,只算向量距离。
第二阶段:线上查询推理(用户提问完整流程)
1 | 用户 Query → Query 改写 → Embedding → 向量检索 → Rerank → 过滤截断 → 组装 Prompt → LLM 生成 |
步骤 1:Query 改写 / 查询增强(可选,提升召回质量)
用户提问经常简短、口语化、有歧义。常见优化:
- 改写:把短问题扩写成更完整检索 query
- 多查询生成:让 LLM 生成多个角度的查询,多路检索再合并
- 历史上下文增强:多轮 RAG,把会话历史融入查询(解决”那违约呢”这类指代)
例:上一轮问”合同有效期”,本轮问”那违约呢”,需要合并历史生成完整 query。
步骤 2:Query 向量化
把处理后的用户查询文本,用同一个 Embedding 模型生成 query 向量。
步骤 3:向量检索(初步召回)
向量库计算 query 向量和库内所有 chunk 向量的相似度,返回 top-k(k=3-8)。
可叠加元数据过滤:例如只检索某文档、某个时间范围的。
⚠️ 向量检索是近似匹配,只看语义相似度,不代表内容真能回答问题,会有噪声。
步骤 4:Rerank 重排序(强烈建议生产开启)
向量召回的 top-k 候选送入 Reranker 重排模型:
输入:用户 query + 候选 chunk
输出:相关性分数,重新排序
结果:把无关的 chunk 丢弃
开源:bge-reranker、cross-encoder
⭐ RAG 效果提升最大的环节之一。向量是粗筛,Rerank 是精细筛选。
步骤 5:后处理:过滤、截断、窗口控制
Rerank 之后拿到真正相关文档片段:
- 过滤分数低于阈值的 chunk
- 拼接剩下的 chunk;总 token 不能超过 LLM 上下文窗口的 RAG 片段配额
- 超长时做截断,避免 prompt 撑爆
这里和你前面的 Agent 上下文工程打通:RAG 检索出来的片段,本质就是外部记忆召回片段。
步骤 6:组装 RAG Prompt
三部分:
1 | 1. System 提示:规则(只使用参考资料回答,资料没有就说不知道,禁止编造,输出引用来源) |
示例模板:
1 | 你是文档问答助手,请严格依据下面参考资料回答用户问题。 |
步骤 7:LLM 生成答案
LLM 接收完整 prompt,基于参考资料输出回答。
步骤 8:输出 + 溯源引用
带上 metadata 来源(文档名 + 页码),方便用户核验。
RAG 架构图
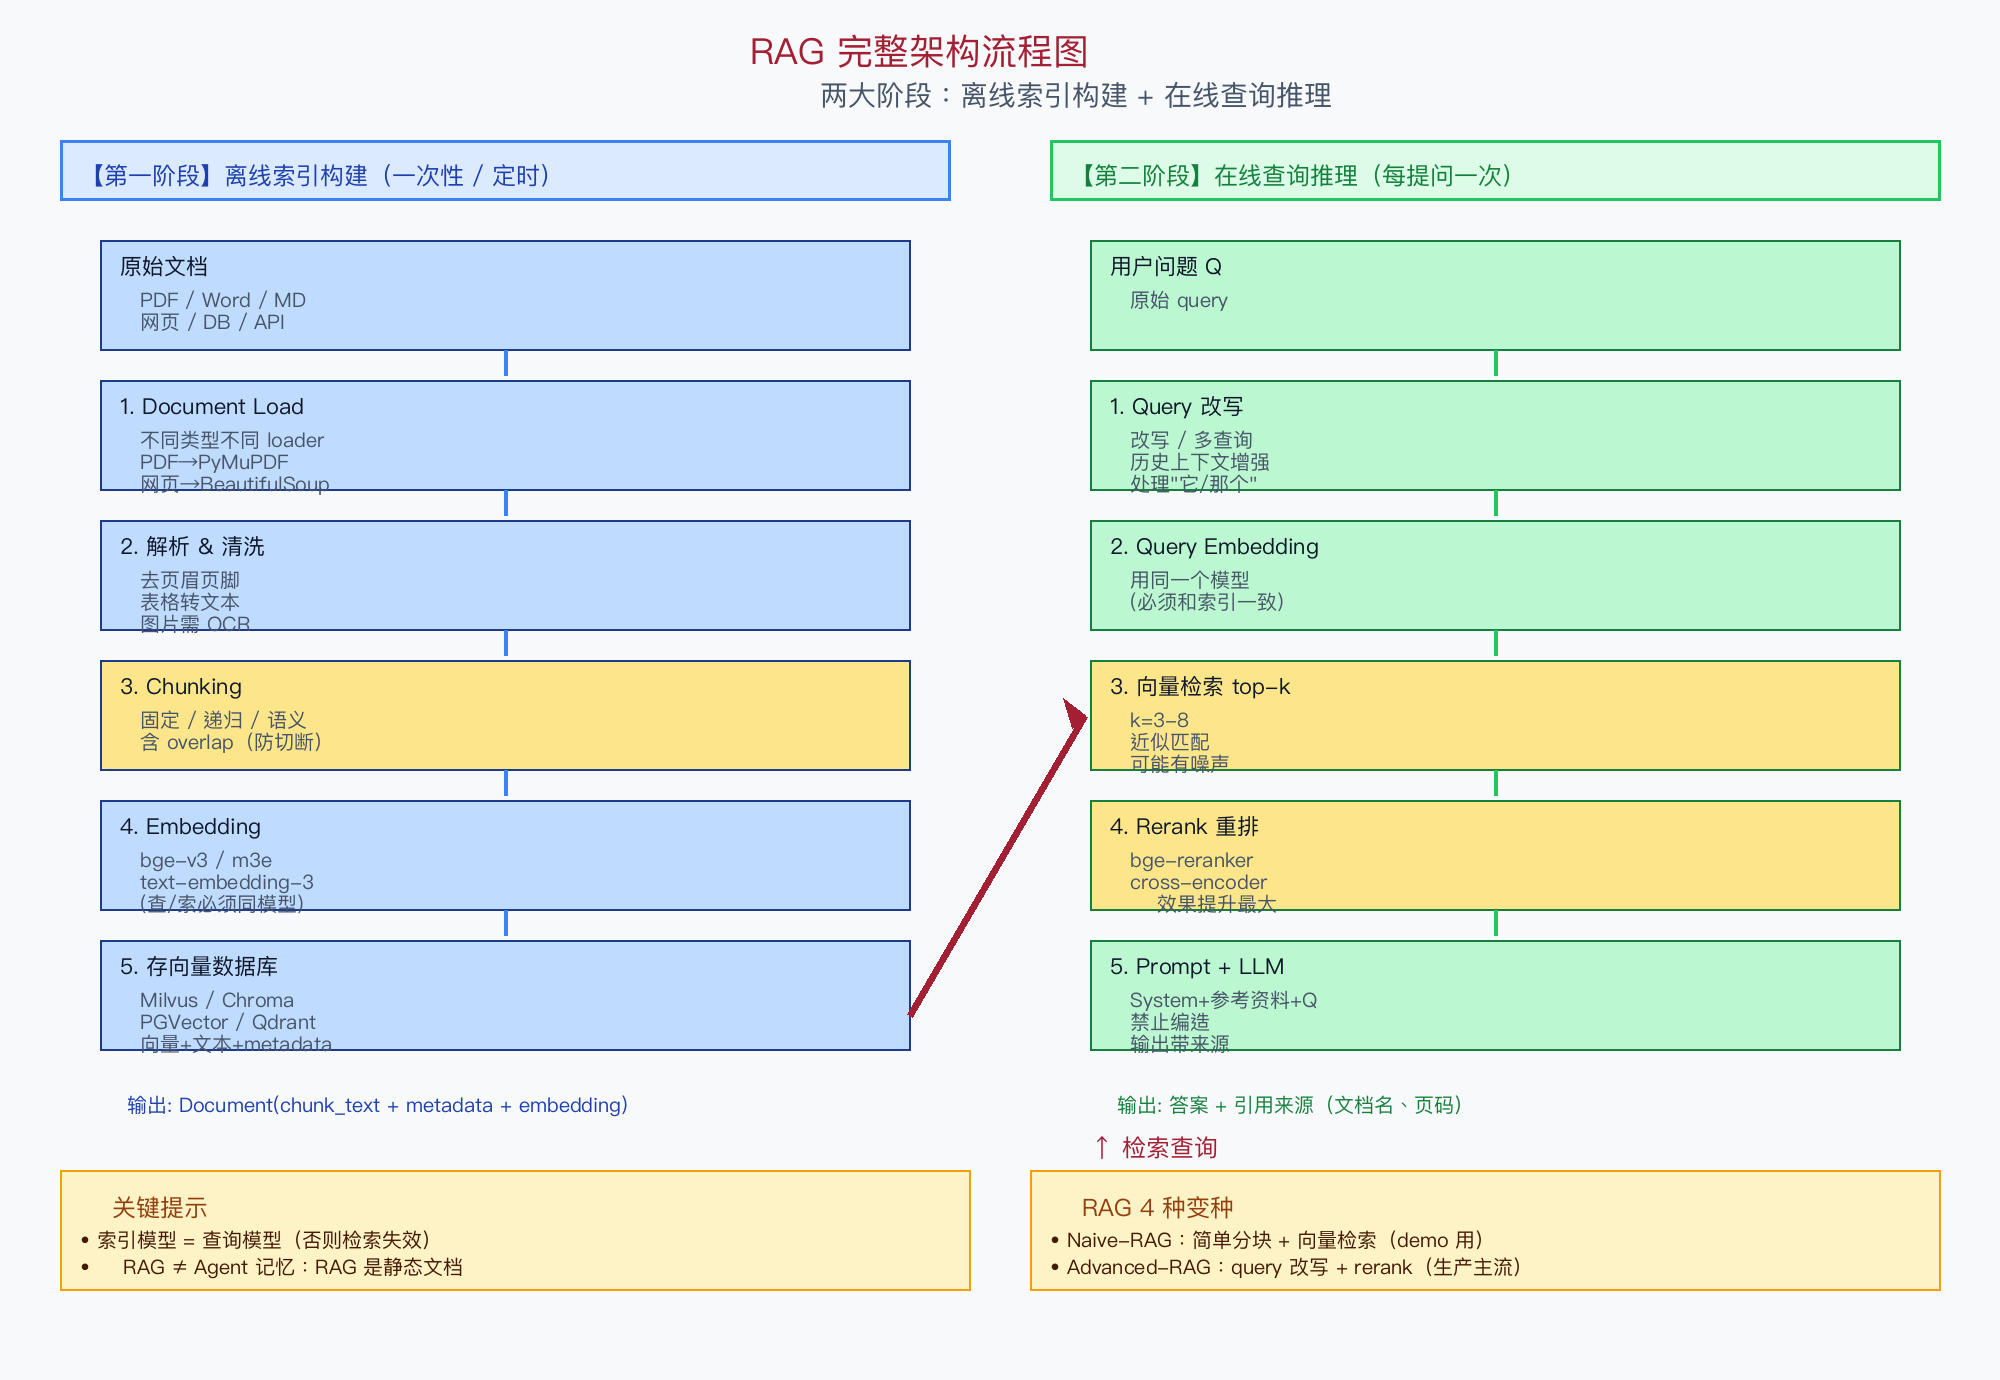
图:RAG 两大阶段 + 8 步在线流程(可放大看)
RAG 常见变种(4 种)
1. Naive-RAG(朴素 RAG)
结构:简单分块 + 向量检索,没有 rerank、没有 query 改写
- ✅ Demo 可用,5 行代码搭起来
- ❌ 生产效果差,幻觉率高
2. Advanced-RAG(高级 RAG)
结构:query 改写 + 多级分块 + rerank + 元数据过滤 + 后处理
- ✅ 效果提升 30-50%
- ✅ 当前主流生产方案
3. Graph-RAG(图谱 RAG)
结构:文档抽取实体关系 → 构建知识图谱 → 结合向量检索
- ✅ 适合复杂多实体关联问题(”张三是李四的什么人”)
- ❌ 构建成本高(需要 LLM 抽取实体)
4. Agent-RAG(Agent 增强 RAG)
结构:RAG 嵌入 Agent 中,Agent 自主判断:
- 是否需要检索?
- 生成什么检索 query?
- 检索多少次?
- 如何融合多个检索结果?
代表:AgentScope、Spring AI Alibaba、OpenAI Agents SDK
Agent 先思考:我是否要调用检索工具?→ 生成 query → 调用 RAG → 拿到片段 → 再继续推理。
RAG 和 Agent 记忆的关系
| 维度 | RAG 知识库 | Agent 长时记忆 |
|---|---|---|
| 数据源 | 静态私有文档 | 动态对话事实 |
| 写入时机 | 离线预构建 | 对话中实时写入 |
| 存储 | 向量数据库 | 向量数据库 + KV |
| 典型内容 | 文档、手册 | 用户偏好、历史问题 |
两者技术底层都是向量检索,但数据源不同。
在线推理时,两类检索片段可以拼入同一个 LLM 上下文:
1 | LLM Prompt = System + (RAG 检索结果) + (Agent 长期记忆) + (短期对话历史) + 用户问题 |
实战常见坑(8 个)
| 坑 | 怎么避 |
|---|---|
| 上下文太长导致 API 报错 | 滑动窗口 + 摘要 + token_limit 强制 |
| 成本暴涨 | 用便宜模型做摘要(gpt-4o-mini 比 gpt-4o 便宜 30x) |
| 指代消解失败 | Query Rewriting + 历史 3 轮一起喂 |
| 跨会话记忆泄露 | session_id 严格隔离 + 用户 ID 过滤 |
| 摘要本身太长 | 递归摘要(摘要的摘要再摘要) |
| 重要信息被截掉 | 关键事实额外提取存向量库,不依赖压缩 |
| LLM 压缩丢关键信息 | 用 Hook 强制压缩,不让 LLM 决定 |
| 长期记忆查询慢 | 用 Redis 缓存 top-K 结果 |
实战选型清单
| 场景 | 推荐方案 |
|---|---|
| 个人 demo | LangChain + Chroma + GPT-4o-mini |
| 中小企业生产 | Advanced-RAG + bge-m3 + Milvus + bge-reranker |
| 复杂实体关系 | Graph-RAG + Neo4j + GPT-4o |
| 企业级多 Agent 系统 | Agent-RAG(AgentScope)+ Spring AI + Qdrant |
| 超大规模(亿级) | Milvus 集群 + GPU rerank + 多级缓存 |
面试怎么答
面试官问 RAG 时,这样答:
「RAG = Retrieval-Augmented Generation,用外部知识库检索补充 LLM 的静态知识。
两大阶段:
- 离线索引:文档 → 清洗 → 分块 → Embedding → 向量库
- 在线查询:Query 改写 → Embedding → 检索 → Rerank → 组装 Prompt → LLM 生成
核心优化点(按效果排序):
- Rerank(效果提升最大)
- Query 改写(处理指代)
- 混合检索(向量 + 关键词)
- 混合分块(语义 + 标题)
常见变种:Naive-RAG(demo 用)、Advanced-RAG(生产主流)、Graph-RAG(实体关系)、Agent-RAG(智能体)」
代码示例(Spring AI + 国产模型)
1 |
|
10 行 Java + Spring AI 跑通一个 RAG demo。
相关阅读
最后更新:2026-09-05